Программа непрерывного образования «Текарт» edu.techart.ru Сессия «Осень 2026»
Модели нейросетей для локального использования:
различия, особенности, рейтинги
24.09.2026
3 место
13 место
Маркетинговый консалтинг
сотрудников
в штате
4
клиентов
и партнеров
в экосистеме «Текарт»
Бизнес-аналитика
пользователей платформы
Дизайн
и брендинг
выполненных проектов
27
Веб-разработка
Отраслевой трек
полносервисные диджитал-агентства (Рейтинга Рунета)
комплексные рекламные агентства (Рейтинга Рунета)
лет на рынке бизнес-аналитики, маркетинга
и digital
Продвижение и реклама
2 место
года работы
Фото и видео
консалтинг
в области маркетинга и PR» (RAEX)
спикеров
Копирайтинг
25 000
38
Маркетинг (комплексное продвижение, SMM, SEO и т.д.), реклама
ТОП-100
в рейтинге работодателей Headhunter*
Мartech, аналитика (технологии, данные, автоматизация, цифровые сервисы)
550
участников
из 2000 компаний
Дизайн, веб-разработка, контент, фото, видео
40 000
10 000+
Маркетинговый анализ и стратегия
160
Организационное развитие
* среди компаний до 250 сотрудников
Отраслевой трек
Основные треки программы:
Маркетинговая стратегия, аналитика, прогнозирование, дизайн, веб-разработка, продвижение и реклама
Ключевые компетенции «Текарт»
Программа непрерывного образования для руководителей по маркетингу
Программа осенней сессии 2026
Новые ИИ-инструменты
в Битрикс24: агенты, Коворк, Вайбкод
Реклама у блогеров.
Где размещать и как запускать
Методы обоснования и принятия управленческих решений
Закупочная деятельность:
аналитика, предтендерные исследования, аудит
Digital-реклама во второй
половине 2026: возможности, стратегии, ошибки
Создание цепочек триггерных рассылок в сервисе Unisender
29 октября
12 ноября
Архитектура, проектирование
и безопасность сложных
веб-представительств
26 ноября
Юридические аспекты
современного сайта
Cостояние и прогнозы
строительной отрасли и рынков основных строительных материалов
22 октября
Модели нейросетей
для локального использования:
различия, особенности, рейтинги
Основные digital-инструменты продвижения в B2B
15 октября
Комплексная безопасность
и IT-сопровождение сайтов
19 ноября
8 октября
17 сентября
24 сентября
1 октября
3 сентября
10 сентября
План вебинара
05
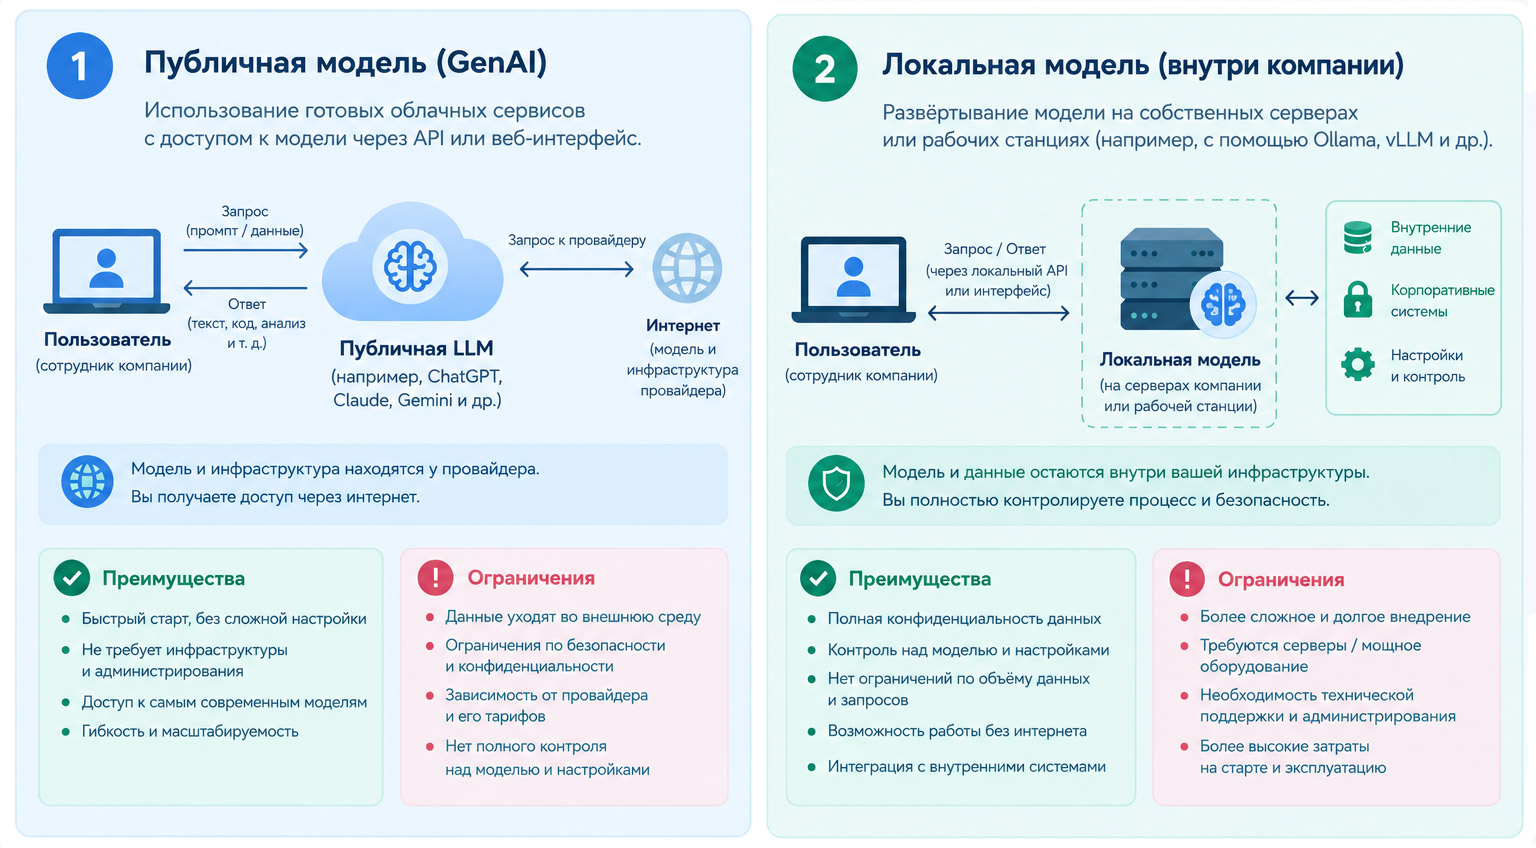
Что такое локальная нейросеть
/ 01
Что такое локальная нейросеть
07
Локальная модель ≠ полностью изолированная система
Локально можно запускать модели:
Даже при локальной LLM данные могут уходить наружу через внешние API, поиск, MCP / инструменты, сторонние интеграции.
на рабочем компьютере
на edge-устройствах
на собственной рабочей станции
на сервере компании
Зачем запускать модели локально
08
Локальная модель не означает автоматически более дешёвую или качественную.
Контроль над данными
Независимость от сервиса
Контроль над инфраструктурой
Стоимость
Внутренние документы, CRM-данные, коммерческая информация не должны покидать внутренний контур.
Нет постоянной зависимости от провайдера, API, тарифов и лимитов.
Компания сама определяет, где работает модель,
кто имеет доступ, какие версии и как хранятся данные.
Экономика зависит от загрузки инфраструктуры.
Когда локальный запуск имеет смысл
09
Это другой вариант организации AI-инфраструктуры.
Чем отличаются современные модели
/ 02
Как читать название модели
11
Qwen3
Instruct
A3B
В названии могут быть указаны:
настроена на выполнение пользовательских инструкций
30B
размер
количество активных параметров
специализация
Instruct, Thinking, Chat
…
Qwen3-30B-A3B-Q4_K_M
MoE, Dense
квантование
семейство
архитектура
количество параметров всего
режим reasoning
версия
Qwen3-30B-A3B-Instruct
Параметры модели
12
Размер модели — только один из параметров выбора.
На результат влияют:
Параметры — это внутренние коэффициенты, в которых модель хранит выученные закономерности.
Больше параметров — как правило, выше качество, но и выше требования к памяти.
Архитектура: Dense и Mixture of Experts
13
Dense
Mixture of Experts
(MoE, Сети экспертов)
Qwen3-30B-A3B — 30 млрд. всего / 3 млрд. активных
Gemma 4 26B A4B — 26 млрд. всего / 4 млрд. активных
Плотные модели активируют все параметры для каждого входного сигнала, тогда как модели MoE выборочно активируют только определённые подсети-эксперты в зависимости от входных данных, что значительно снижает объём вычислений на один вывод.
Активные параметры ≠ объём памяти, необходимый для загрузки модели. Все необходимые веса нужно хранить.
Каждый токен обрабатывается всей моделью.
Несколько экспертных подсетей, для токена активируется только часть.
30B всего
30B total
30B параметров участвуют в вычислениях
3B используются
Контекстное окно
14
Context window — сколько токенов модель может учитывать в одном запросе / диалоге.
Чем длиннее диалог или документ, тем больше дополнительной видеопамяти уходит на так называемый KV-кэш.
Если планируете работать с длинными текстами или большими файлами кода, закладывайте запас памяти сверх «голого» размера модели, а на пределе бюджета берите модель на ступень меньше, чтобы осталось место под контекст.
Большое окно не означает автоматически, что «модель лучше понимает длинные документы».
4K
128K
1M+
256K
32K
Специализация моделей
15
Reasoning
Embedding
General
Coding
Vision / Multimodal
Что влияет на требования к компьютеру и скорость работы
/ 03
Что происходит во время инференса
14
Это процесс, в котором обученная модель обрабатывает новые данные и выдает результат. Например, отвечает на вопрос, распознает изображение
Откуда берётся потребление памяти
18
В очень упрощённом виде:
=
+
+
+
Чем больше контекст и чем больше одновременно обрабатываемых запросов, тем больше памяти потребуется.
Современные инструменты позволяют отдельно оценивать память с учётом размера контекста и GPU offload.
Размер файла модели ≠ полное потребление памяти.
Особенно важен KV cache
Память
KV cache
накладные расходы
рабочая
память
веса модели
CPU, GPU и память
19
GPU
VRAM
CPU
Для большинства крупных моделей GPU позволяет значительно ускорить инференс.
RAM
G
Особенно важна при запуске на видеокарте. Недостаток VRAM →
часть модели приходится держать в RAM.
Можно запускать модели без дискретной видеокарты. Но обычно это означает меньшую скорость генерации.
V
Позволяет запускать более крупные модели, особенно при CPU-инференсе или частичном GPU offload.
C
R
Почему квантование так важно
20
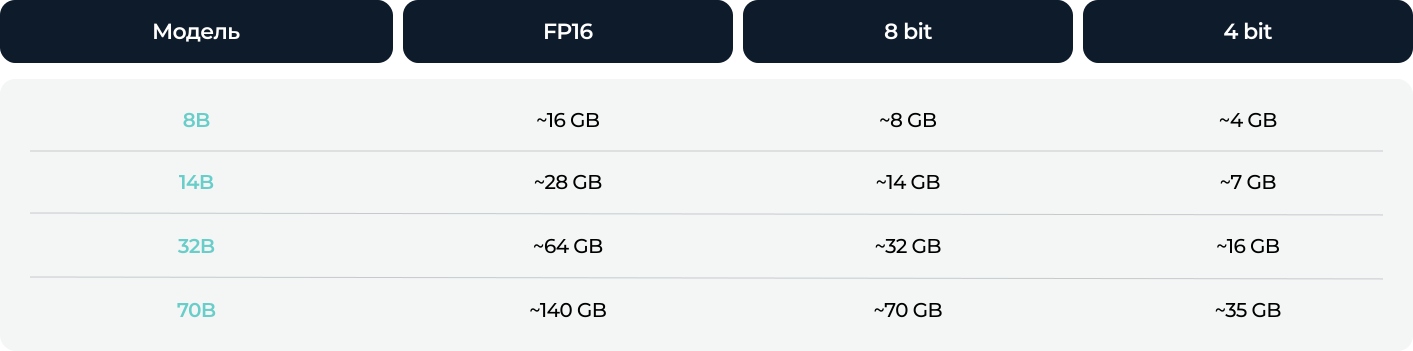
Исходная модель может хранить веса, например, в:
но одновременно — потенциальная потеря качества
используются форматы Q4, Q5, Q6, Q8 и другие.
меньше бит → меньше памяти
В экосистеме llama.cpp
Размер файла модели ≠ полное потребление памяти.
FP16 / BF16 → 16 бит
4 bit
8 bit
2 bit
3 bit
Один модельный ряд — разный объём
21
используются форматы Q4, Q5, Q6, Q8 и другие.
Это только оценка веса модели.
Память ≈ количество параметров × битность / 8
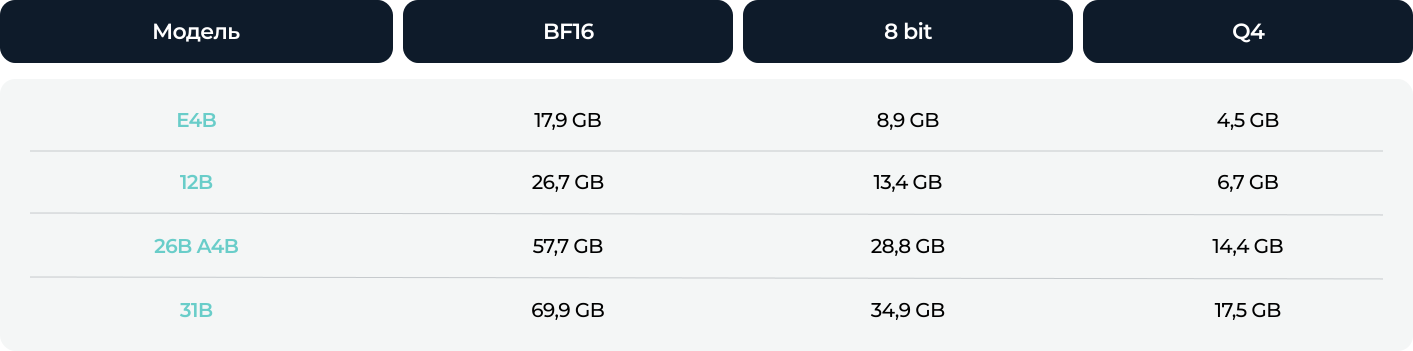
Практический пример: Gemma 4
22
Google приводит ориентировочные требования к памяти (с учётом ~20% накладных):
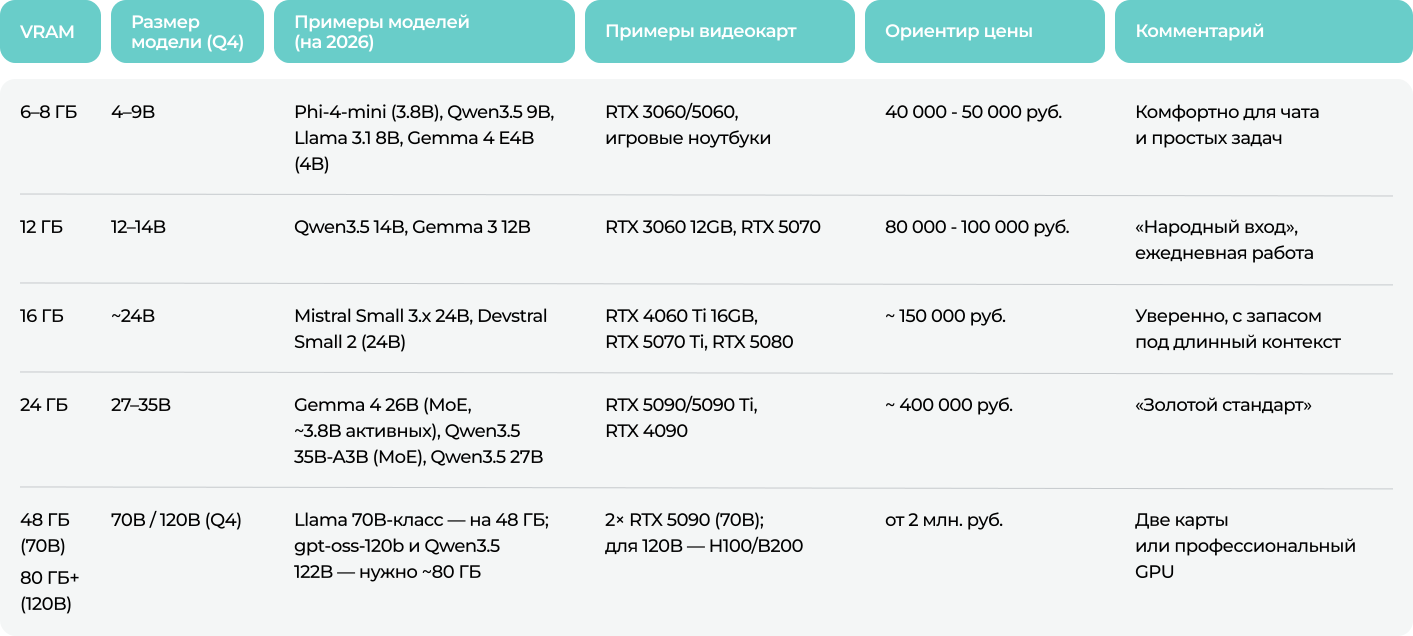
Примеры конфигураций
23
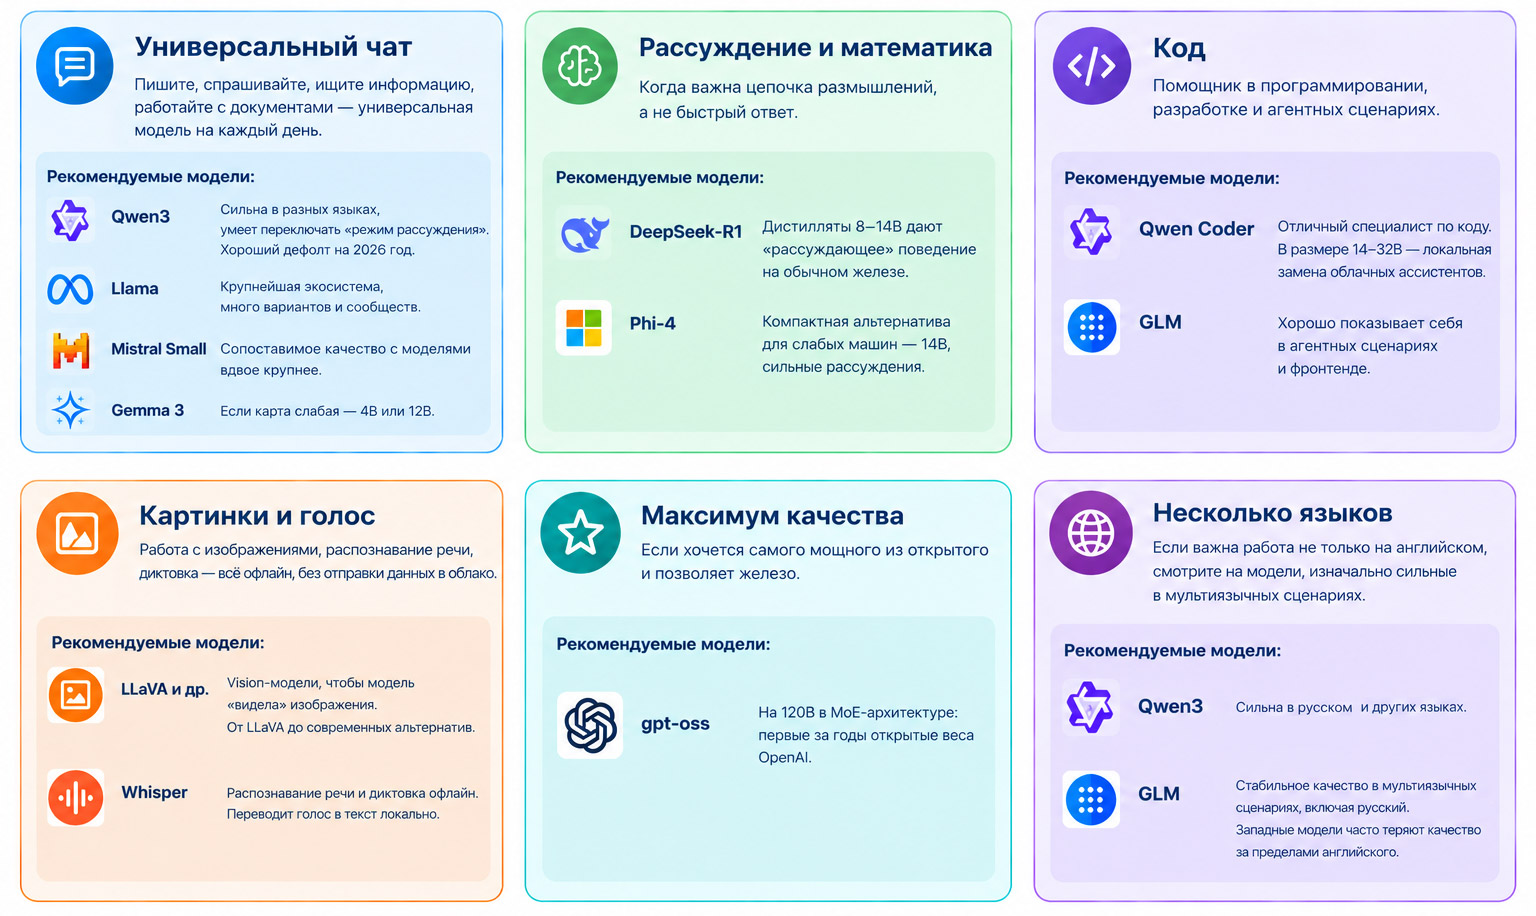
Основные семейства локальных моделей
/ 04
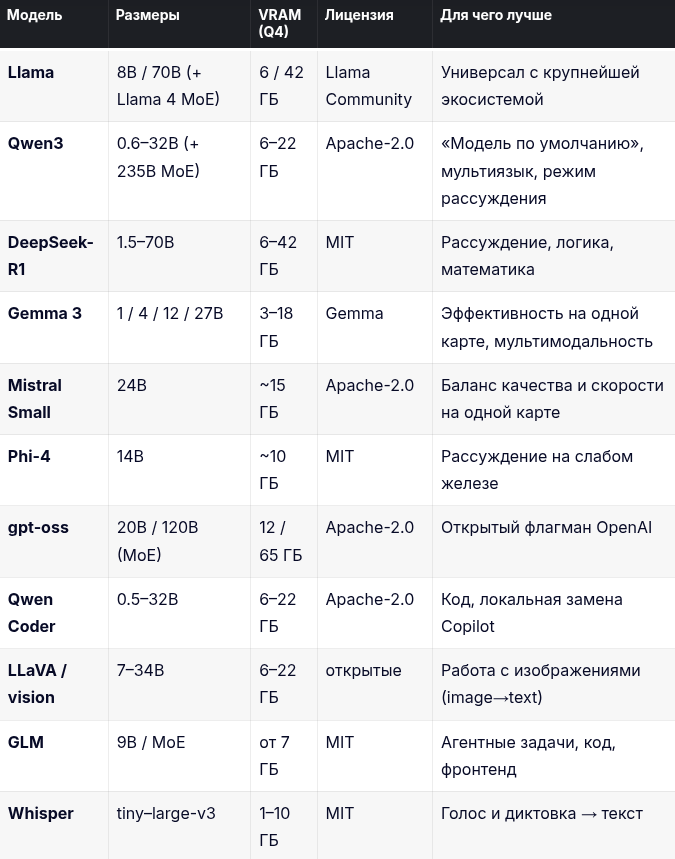
Карта основных семейств
25
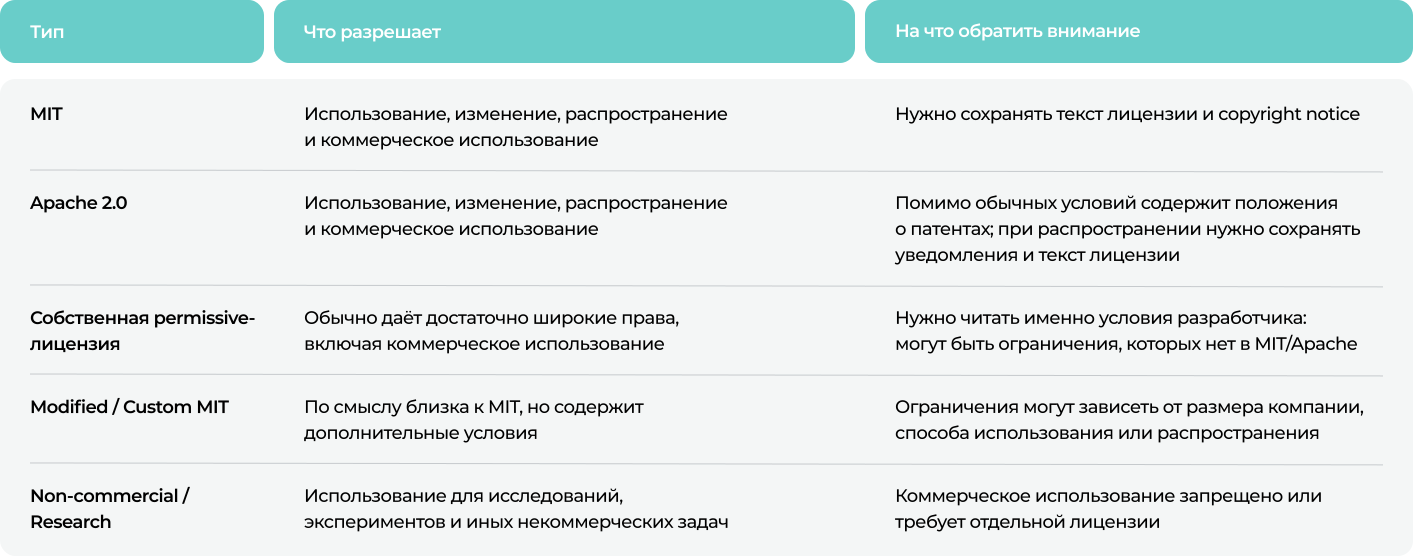
Типы лицензий
26
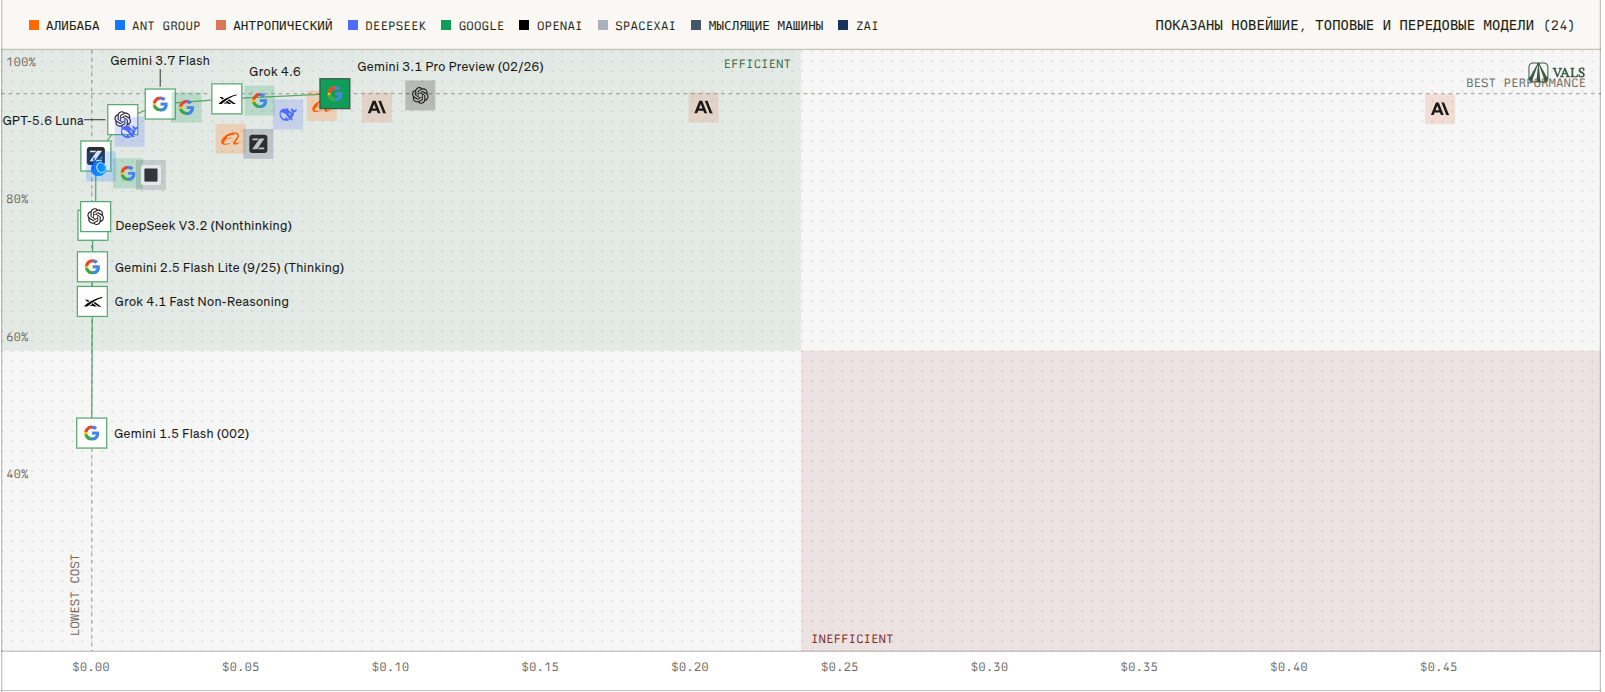
Рейтинги и бенчмарки: как сравнивать модели
/ 05
Что такое benchmark
28
Бенчмарк — стандартизированный набор задач, по которому сравнивают модели.
Код
Общие знания и reasoning
Мультимодальность
Проблема: один benchmark проверяет только определённый аспект работы нейросети.
Три типа рейтингов
29
Специализированные лидерборды
2
Модель решает заранее подготовленный набор задач.
Минус: результат зависит от конкретного теста.
coding · reasoning · long context · multimodal · multilingual
Пользователи сравнивают ответы двух моделей.
Плюс: воспроизводимость
Hugging Face разделяет официальные оценки,
community leaderboards и другие.
Arena формирует рейтинг на основе большого числа сравнений.
1
3
Бенчмарк GPQA
30
Бенчмарки по конкретным задачам
31
Диалог, общение, инструкции
Сложные рассуждения
Русский язык
Знания и общая эрудиция
Программирование
Длинные документы
Следование инструкции
Chatbot Arena / human preference
GPQA, AIME, HMMT
MERA / ruMMLU
MMLU / MMLU-Pro / MMLU-Redux
SWE-bench Verified, LiveCodeBench
LongBench / LongBench v2
IFEval
Бенчамарки отличаются от реальных задач
32
Высокая позиция в рейтинге не гарантирует, что модель лучше справится с:
Benchmark отвечает: «Что умеет модель в стандартизированном тесте».
Ваш тест отвечает: «Подходит ли она нам».
российскими юридическими документами
извлечением данных из CRM
вашими текстами
классификацией лидов
внутренними регламентами
анализом ваших документов
Как выбрать модель под свои задачи
/ 06
Алгоритм выбора
34
конфиденциальность, локальность, доступ в интернет, безопасность
например, 14B Q4 вместо 32B FP16
текст / анализ / код / документы / изображения / рассуждения
VRAM, RAM, CPU, скорость памяти, GPU
быстрый помощник
или максимальное качество рассуждения
тест на собственных данных
Модели под конкретные задачи
35
Алгоритм выбора
36
задача → качество → стоимость запуска
Выбирать локальную нейросеть нужно не по названию и не по позиции в рейтинге, а по сочетанию трёх факторов:
ЗАДАЧА
РАЗМЕР
ТРЕБУЕМОЕ КАЧЕСТВО
КОНТЕКСТ
МОДЕЛЬ ДЛЯ ПРОДАКШЕНА
СЕМЕЙСТВО МОДЕЛЕЙ
ТЕСТ НА СВОИХ ДАННЫХ
ТРЕБОВАНИЯ
К ДАННЫМ
КВАНТОВАНИЕ
Пример конфигурации для пилотного проекта
37
GPU: 16–24 ГБ VRAM
Оперативная память: 64 ГБ
Накопитель: NVMe
Семейство моделей: Qwen
Фреймворк для запуска LLM: Ollama / LM Studio
Веб-интерфейс для чата: Open WebUI
Такой стенд позволяет проверить:
Предпосылки к переходу на серверную архитектуру:
Один запрос — несколько моделей
38
Смотреть не только на качество ответа:
Сравнить:
время до первого токена (TTFT)
размер модели
средняя модель
маленькая модель
tokens/sec
качество результата
reasoning-модель
объём памяти
необходимость повторного запроса
«Проанализируй описание продукта, выдели целевую аудиторию, преимущества, недостатки и предложи структуру рекламного сообщения».
Демонстрация на одной рабочей задаче:
Наши материалы по теме
39
19.03.2026
18.06.2026
27.08.2026
23.04.2026
20.08.2026
13.11.2025
Персональное консультационное мероприятие по теме этого вебинара
Особенности:
Программа может быть реализована в различных вариантах:
Дадим конкретные рекомендации и инструкции
от 1 часа до 2 дней.
Будем разбирать именно ваши кейсы
Длительность:
Подготовим пошаговое руководство для решения проблемы
При необходимости мы можем собрать комбинацию из нескольких удобных вам вариантов обучения.
онлайн, оффлайн, гибрид.
Форматы:
Максимально адаптируем контент под потребности компании
Интересуюсь
Ответим на любые вопросы
Подсветим специфику ниши
Андрей Титенко
Интегрированный маркетинг и PR
Стратегия, аналитика, контент, разработка, продвижение
+7 495 790 75 91
Образовательная программа
Рабочий пульс: проекты, кейсы, публикации
Релевантные услуги «Текарт»:
IT-решения и веб-разработка
Работа в «Текарт»
Непрерывное образование
для руководителей
по маркетингу
Заместитель директора практики интегрированного маркетинга
Креативное агентство
Непрерывное образование
для руководителей
по маркетингу
Фотоагентство
Дизайн-бюро
Аналитика и бизнес-планирование
Маркетинговая группа «Текарт»